SEO
robots.txt e sitemap: o que cada um faz, e o que nenhum faz
O robots.txt controla rastreamento, não indexação. O sitemap sugere URLs, não garante que entrem. Veja o que cada arquivo resolve e os erros que travam sites inteiros.
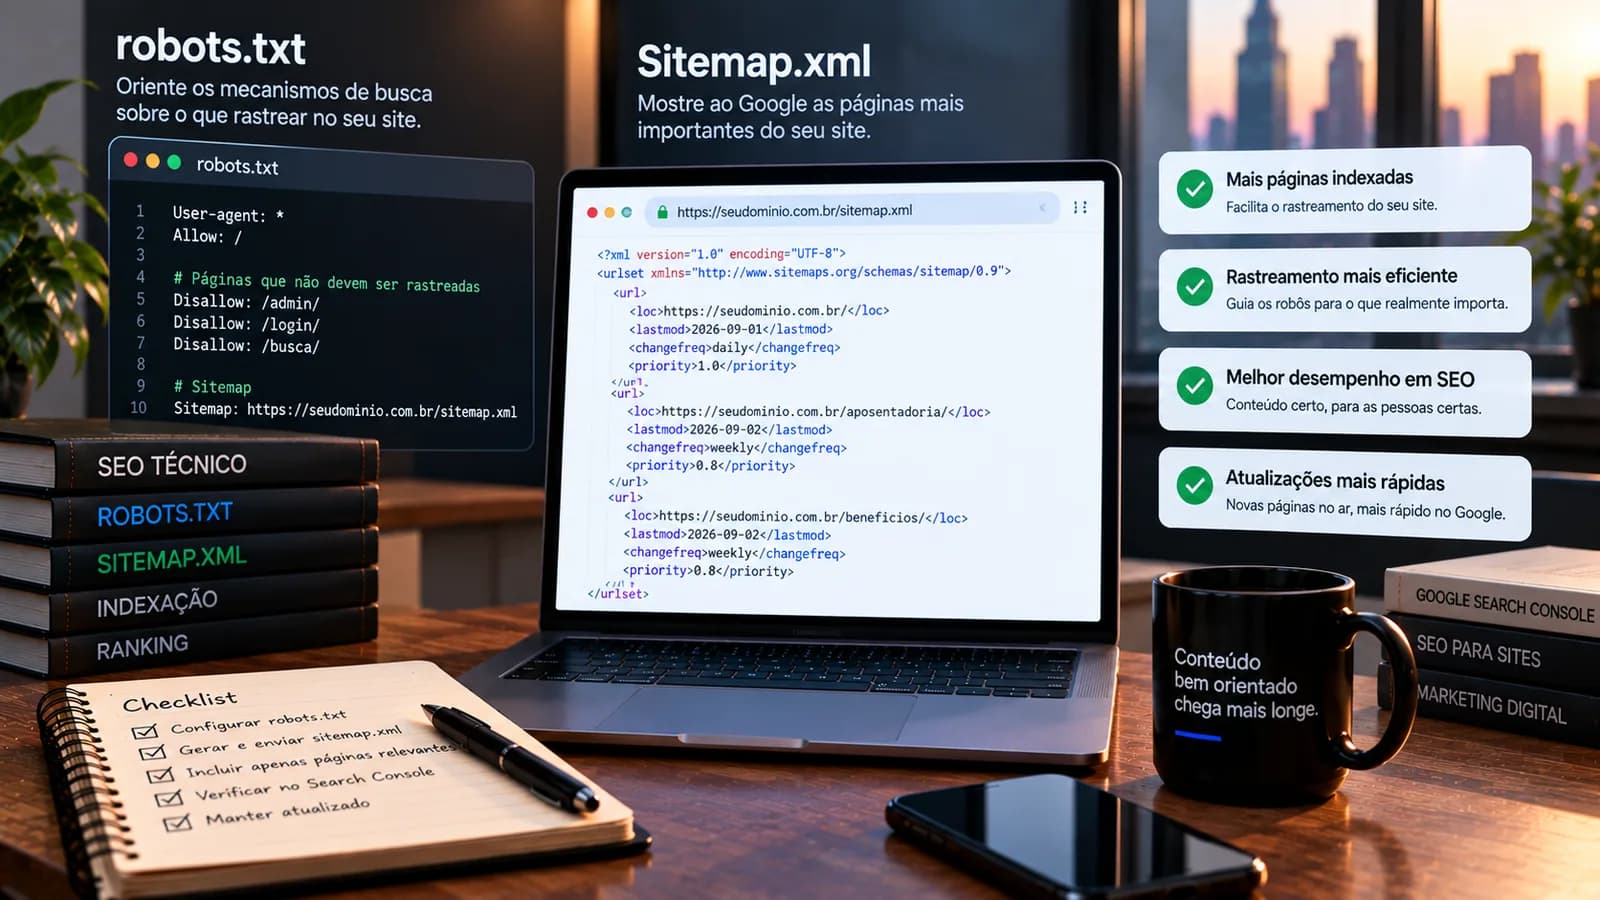
Resposta rápida
O robots.txt diz a quais URLs o robô pode acessar: ele controla rastreamento, não indexação, e uma página bloqueada ali ainda pode aparecer na busca se outros sites apontarem para ela. O sitemap.xml lista as URLs que você considera importantes e ajuda o Google a descobri-las, mas não garante indexação nem melhora posição. Os dois são sinais de descoberta. Nenhum dos dois remove uma página do índice, e é aí que está o erro mais caro: bloquear no robots.txt uma página que se queria desindexar impede o Google de ler a instrução que faria isso.
Os dois arquivos aparecem juntos em toda lista de SEO técnico e fazem coisas diferentes. A confusão entre eles é responsável por alguns dos erros mais destrutivos que eu já vi em site em produção.
A distinção que resolve quase tudo: robots.txt fala sobre acesso, sitemap fala sobre existência. Nenhum dos dois fala sobre indexação.
robots.txt: onde o robô pode entrar
Um arquivo de texto na raiz do domínio, em exemplo.com.br/robots.txt, que declara quais caminhos cada robô pode acessar.
User-agent: *
Disallow: /admin/
Disallow: /carrinho/
Allow: /

Sitemap: https://exemplo.com.br/sitemap.xml
O que ele serve para fazer, de verdade:
- Poupar rastreamento em áreas sem valor de busca: painel administrativo, carrinho, resultados de busca interna, combinações infinitas de filtro.
- Evitar carga de robôs em endpoints caros.
- Apontar o sitemap, que é a linha mais útil e a mais esquecida.
O que ele não faz: tirar uma página do Google. Bloqueio é sobre leitura, não sobre presença no índice.
Duas armadilhas adicionais que valem conferir hoje:
O bloqueio total que foi para produção. Ambiente de desenvolvimento costuma usar Disallow: / para não ser indexado. Quando esse arquivo sobe junto com o site, o domínio inteiro sai do índice. É a primeira coisa que eu checo em site novo que não aparece em nada.
Bloquear CSS e JavaScript. O Google renderiza a página para avaliá-la. Sem acesso aos arquivos de estilo e script, ele vê um layout quebrado e conteúdo que talvez nem apareça.
sitemap.xml: quais URLs você considera importantes
Um arquivo que lista as URLs que deveriam estar no índice, com a data da última modificação de cada uma.
<url>
  <loc>https://exemplo.com.br/pagina/</loc>
  <lastmod>2026-09-12</lastmod>
</url>
Ele ajuda na descoberta e nada mais. Não é um pedido de indexação nem um sinal de importância que melhore posição.
Quatro regras que definem se ele serve para algo:
Só URLs indexáveis. Se o sitemap lista uma página com noindex, bloqueada no robots.txt ou que redireciona, você está mandando sinais contraditórios sobre a mesma URL.
Só URLs canônicas. A versão listada precisa ser a mesma que a página declara em rel="canonical".
lastmod honesto. Data real de alteração de conteúdo. Sitemap que marca todas as páginas como modificadas hoje, todos os dias, perde credibilidade como sinal e deixa de ser usado.
Gerado, nunca escrito à mão. Sitemap manual desatualiza na primeira publicação em que alguém esquecer de atualizá-lo, e um sitemap desatualizado é pior que nenhum.
Quer saber por que parte do seu site não aparece na busca?
A tabela que resolve a confusão
| Objetivo | Ferramenta correta | O que não usar |
|---|---|---|
| Impedir que o robô acesse | robots.txt | noindex |
| Remover do índice | noindex na página | robots.txt |
| Ajudar a descobrir URLs | sitemap.xml | robots.txt |
| Escolher entre URLs equivalentes | rel="canonical" | robots.txt |
| Consolidar página que não existe mais | redirect 301 | noindex |
Em que ordem conferir
Em site que não aparece na busca, esta sequência encontra a causa na maioria dos casos:
- Abra
seudominio.com.br/robots.txtno navegador. Se houver umDisallow: /sem restrição, o diagnóstico terminou aqui. - Veja o código-fonte de uma página importante e procure por
noindex. Ele costuma vir de configuração de plugin ou de uma opção de privacidade da plataforma. - Confirme que o sitemap existe e que abre no navegador, listando as URLs que você espera.
- No Search Console, compare URLs enviadas no sitemap com páginas efetivamente indexadas.
O detalhamento de cada motivo de exclusão está em por que o Google não indexa minhas páginas.
Fontes e referências
- Robots.txt Introduction and GuideGoogle Search Central
- What Is a SitemapGoogle Search Central
Perguntas frequentes
- Não, e com frequência produz o oposto do esperado. Bloqueio impede o robô de ler a página, então ele não vê a tag noindex que removeria de fato. Se outros sites apontam para essa URL, ela pode continuar aparecendo no resultado, agora sem título nem descrição, porque o Google sabe que ela existe e não tem permissão para ler o conteúdo. Para desindexar, é preciso permitir o rastreamento e usar noindex.